ダウンタイムオペレーター画面
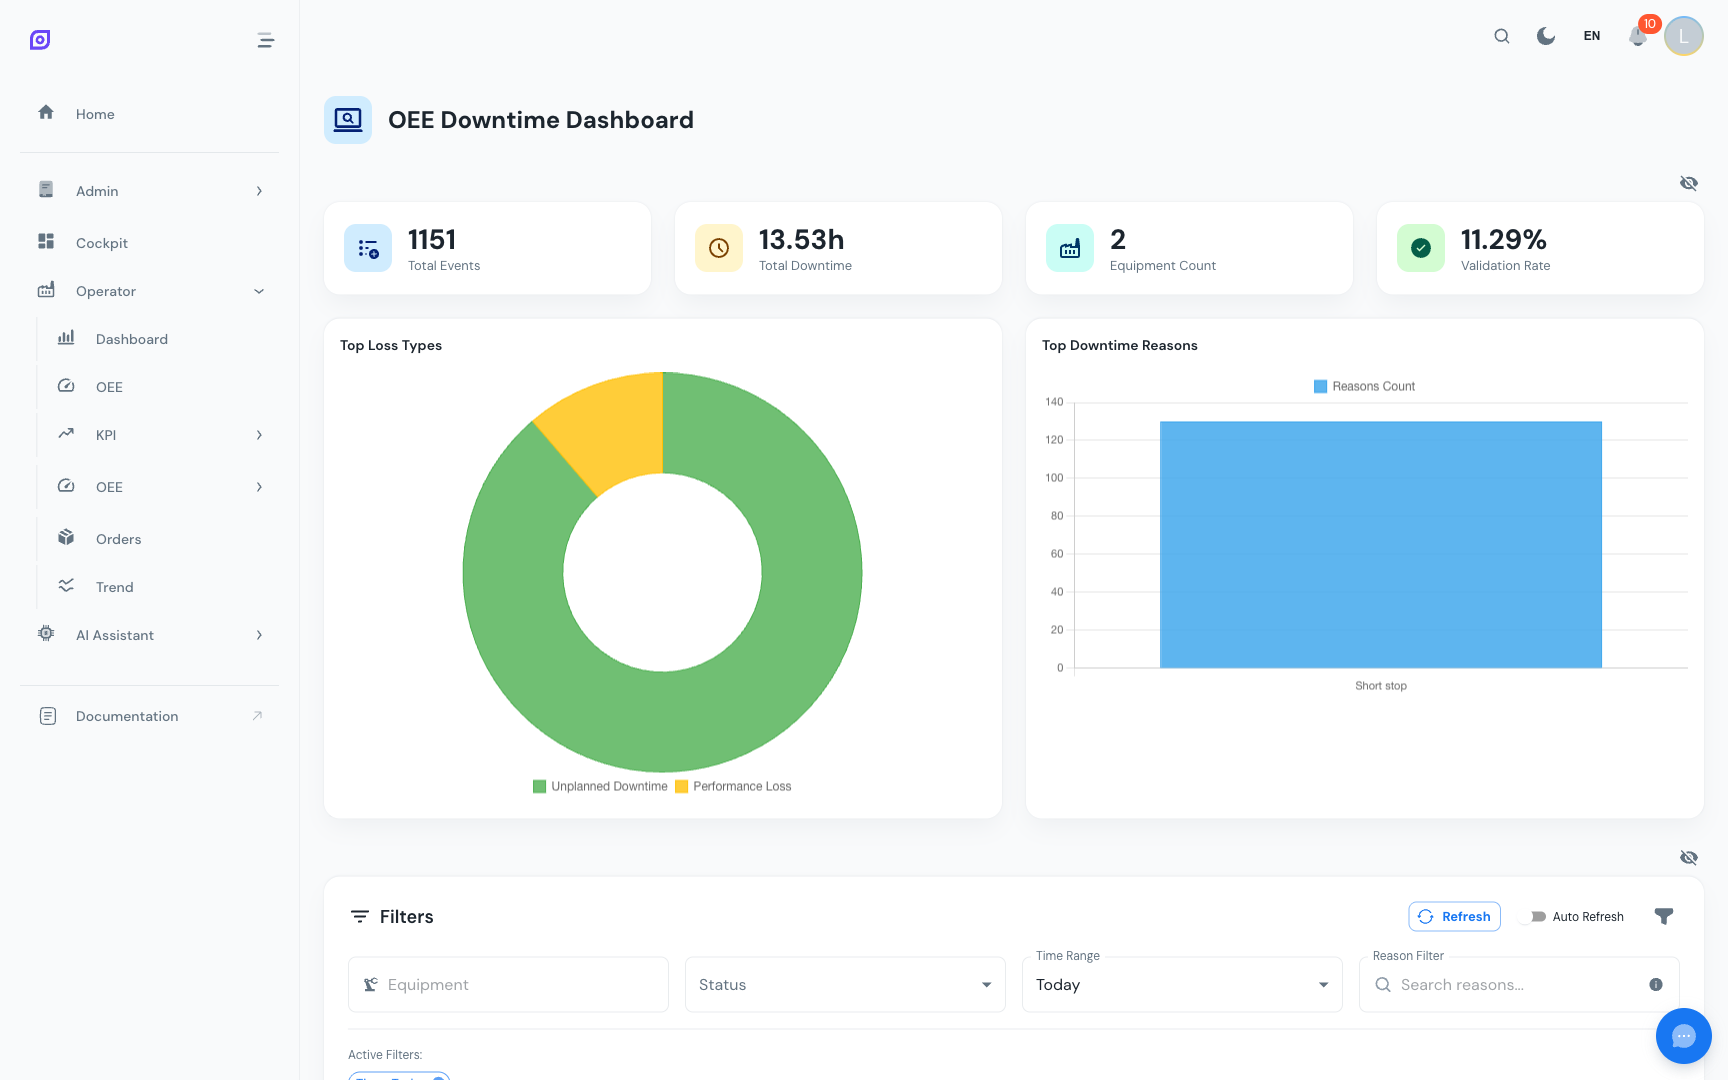
ダウンタイムオペレーター画面は、生産オペレーターの日常的なワークスペースです。選択した設備のすべてのダウンタイム(可用性)イベントを表示し、視覚的なタイムラインを提供し、オペレーターがイベントを理由で分類したり、長いイベントを分割したり、関連するイベントを統合したり、コメントを追加したりすることを可能にします。
この画面はOEE可用性に直接影響します。適切に分類されたイベントは、管理者が時間がどこで失われているかを理解するのに役立ちます。
画面レイアウト
ダウンタイム画面は、上から下に向かって4つのセクションで構成される標準のオペレーター画面レイアウトを使用します。
- ダッシュボードカード: サマリーKPI(総イベント数、総ダウンタイム、検証率など)
- フィルター: 設備、時間範囲、ステータス、理由検索、短い停止トグル
- タイムライン: イベントを色付きピルとして表示する折りたたみ可能な視覚的タイムライン
- データテーブル: インラインアクション付きのすべてのイベントを一覧表示するDataGrid
ダッシュボードカード
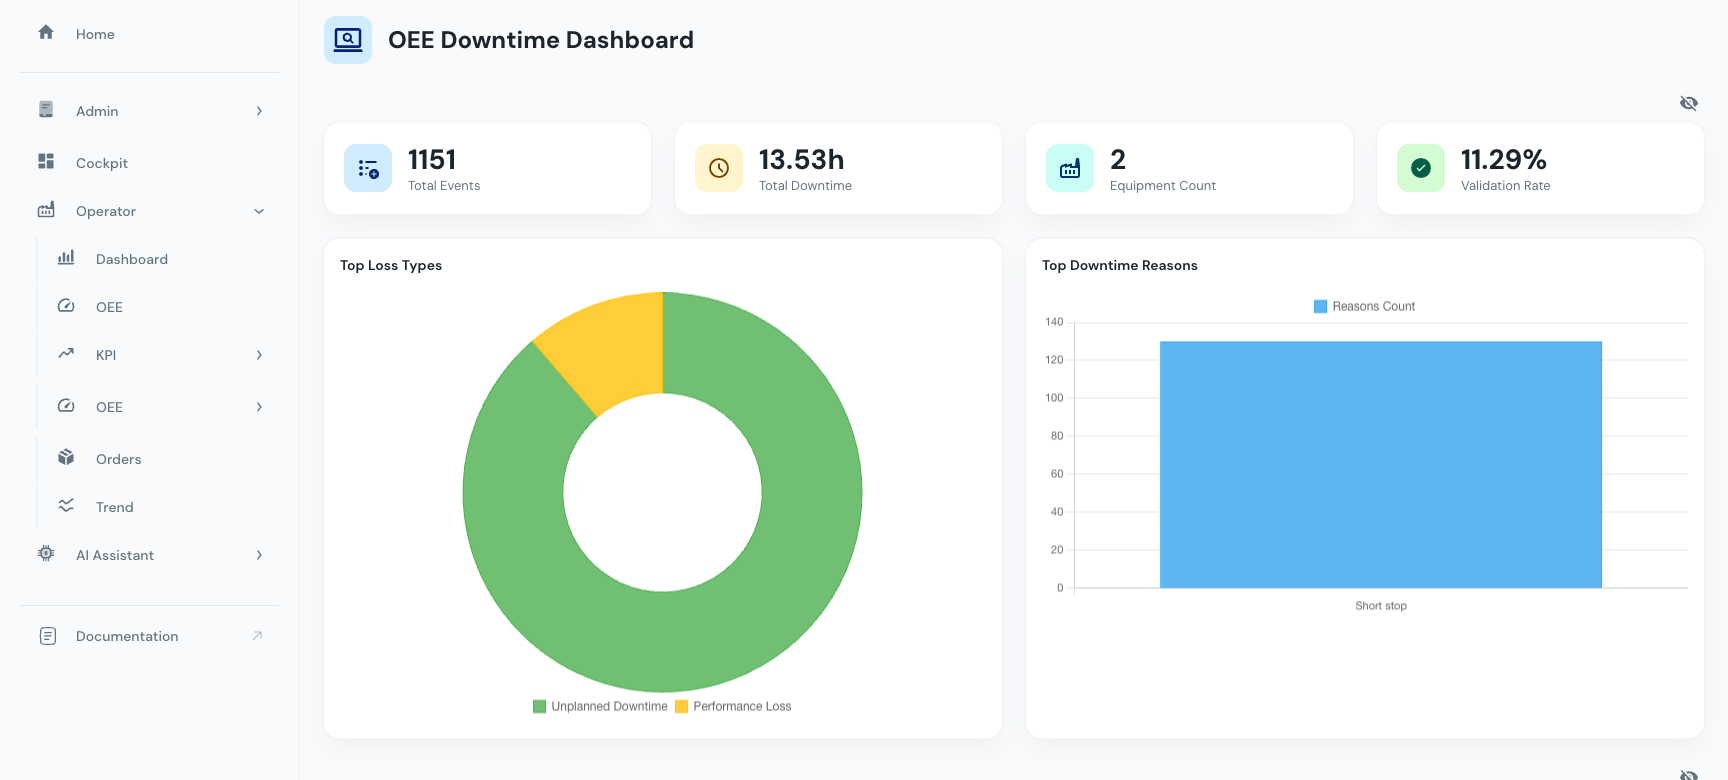
上部のサマリーカードは即座に概要を提供します。
| カード | 説明 |
|---|---|
| 総イベント数 | 選択期間中のダウンタイムイベント数 |
| 総ダウンタイム | すべてのイベント期間の合計(時間と分) |
| 設備数 | イベントが発生した個別設備の数 |
| 平均期間 | イベントの平均期間 |
| 検証済みイベント | 理由が割り当てられたイベント |
| 検証率 | 理由付きイベントのパーセンテージ(目標: 100%) |
| トップ損失タイプ | 最頻出の損失タイプカテゴリ |
| トップ理由 | 最頻出のダウンタイム理由 |
検証率はオペレーターにとって最も重要なKPIの一つです。100%の検証率は、すべてのダウンタイムイベントが理由で分類されたことを意味し、正確な損失分析に不可欠です。
フィルター
フィルターカードは包括的なフィルタリングを提供します。
設備フィルター
検索付きの複数選択ドロップダウンを使用して、1つ以上の設備項目を選択します。階層ツリーにより、個々のマシンまたは生産ライン全体を選択できます。
時間範囲
次から選択します。
- 時間プリセット: 事前定義された範囲(今日、昨日、今週など)
- 絶対モード: 日時ピッカーを使用した特定の開始日時と終了日時
ステータスフィルター
イベントを操作ステータス(例:稼働中、停止、メンテナンス、段取り替え)でフィルタリングします。
理由検索
特定の理由テキストに一致するイベントを検索するために入力します。
短い停止を表示
構成された閾値より短いマイクロ停止イベントを含めるか除外するかを切り替えます。短い停止はノイズを減らすためにデフォルトで非表示です。
自動更新
自動更新を有効にすると、データが30秒ごとに更新されます。手動の 更新 ボタンもオンデマンド更新で利用可能です。
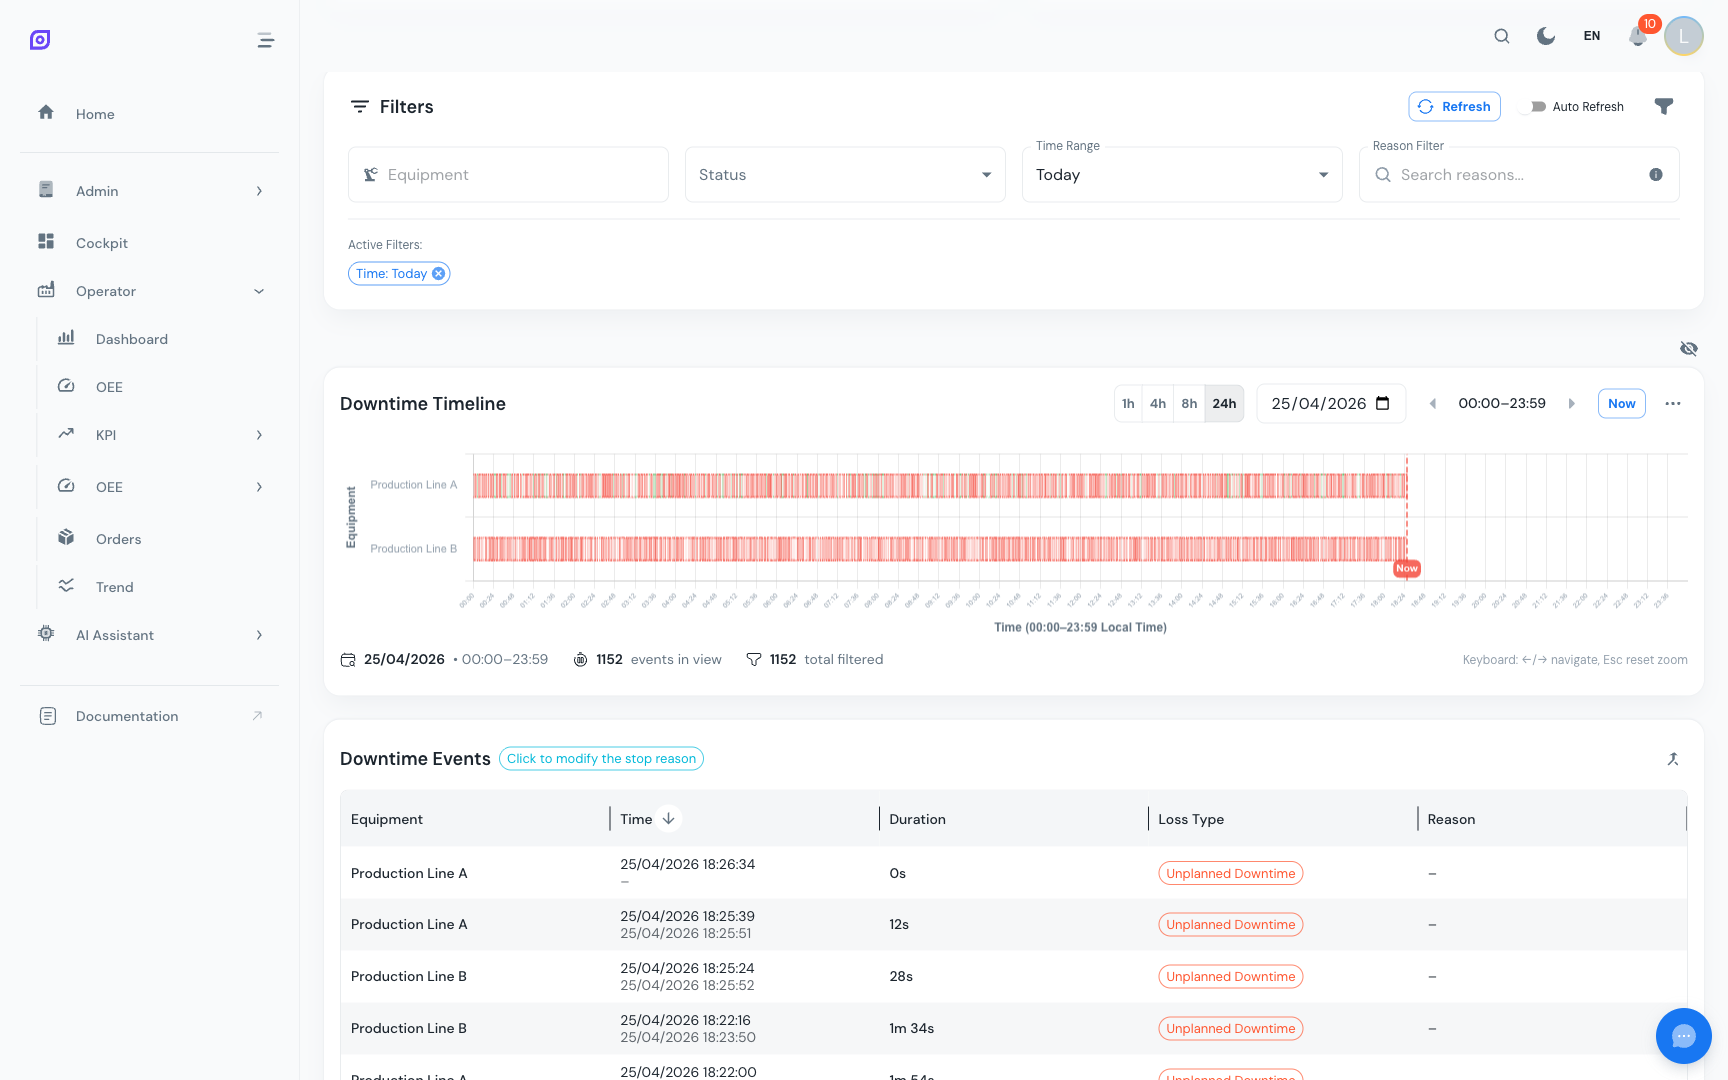
フィルターは変更ごとに即座に適用されます。「適用」ボタンはありません。初回ロード後、フィルター変更はデータをサイレントにリロードします(ロードスピナーなし)。これにより、ビューは応答性が高く感じられます。
タイムライン
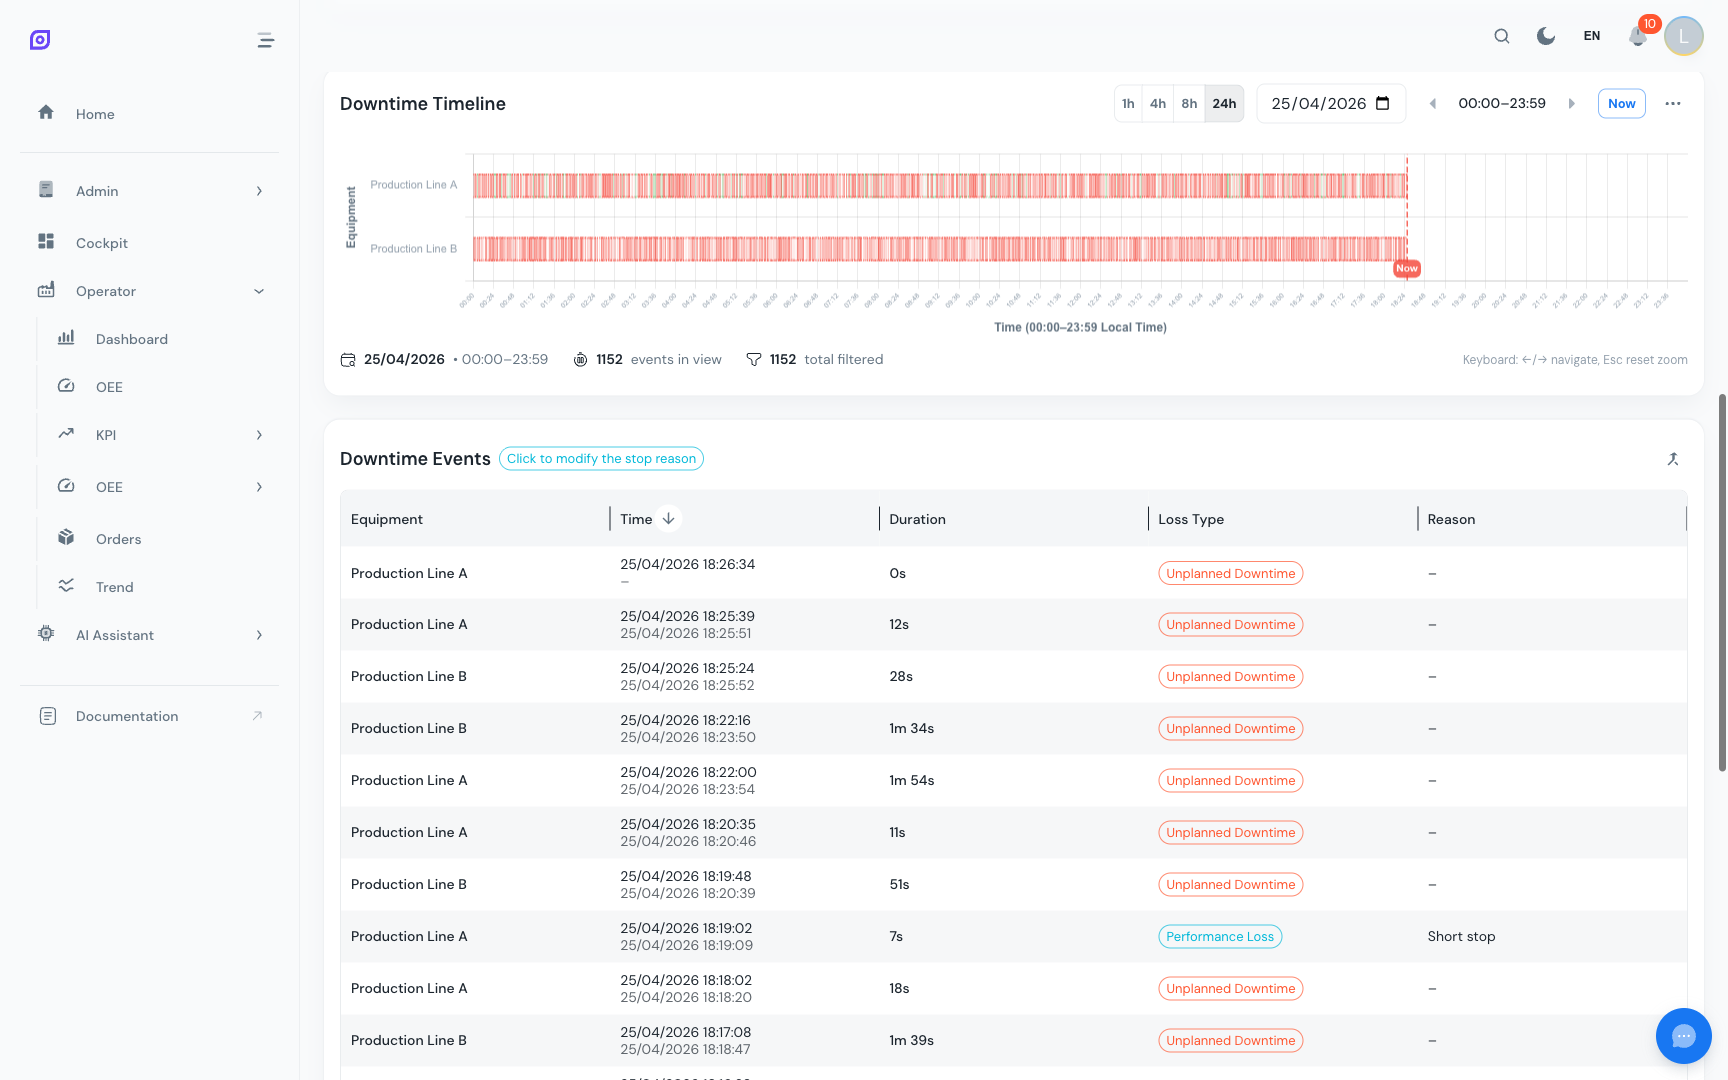
折りたたみ可能なタイムラインセクションは、ダウンタイムイベントを時間軸上の色付き水平ピルとして表示します。各行は1つの設備ラインを表します。
ビューモード
タイムラインが一度に表示する時間の量を制御します。
- 1時間: 最も詳細なビュー、個々の短いイベントを見るのに最適
- 4時間: 半シフト分析に適している
- 8時間: 完全なシフト概要
- 24時間: 1日全体
時間スライダーまたは日セレクタを使用して時間を移動します。
カラーモード
2つのカラーモードを切り替えます。
| モード | 説明 |
|---|---|
| 検証 | 緑 = 検証済み(理由割り当て済み)、赤 = 未検証 |
| 損失タイプ | 各損失タイプには独自の色があり、損失タイプ構成と一致します |
タイムラインの操作
- ピルをクリック すると、イベントを選択して理由選択パネルを開きます
- 2つのピルをShift+クリック すると、統合操作のために選択します
- ホバー すると、イベントの詳細(開始時刻、終了時刻、期間、理由、設備)のツールチップが表示されます
- チャート上でブラッシング(クリック&ドラッグ)して時間範囲に ズーム します
設備の選択
複数の設備がフィルターにある場合、タイムラインの上の設備チェックボックスを使用して、表示するラインを制御します。
データテーブル
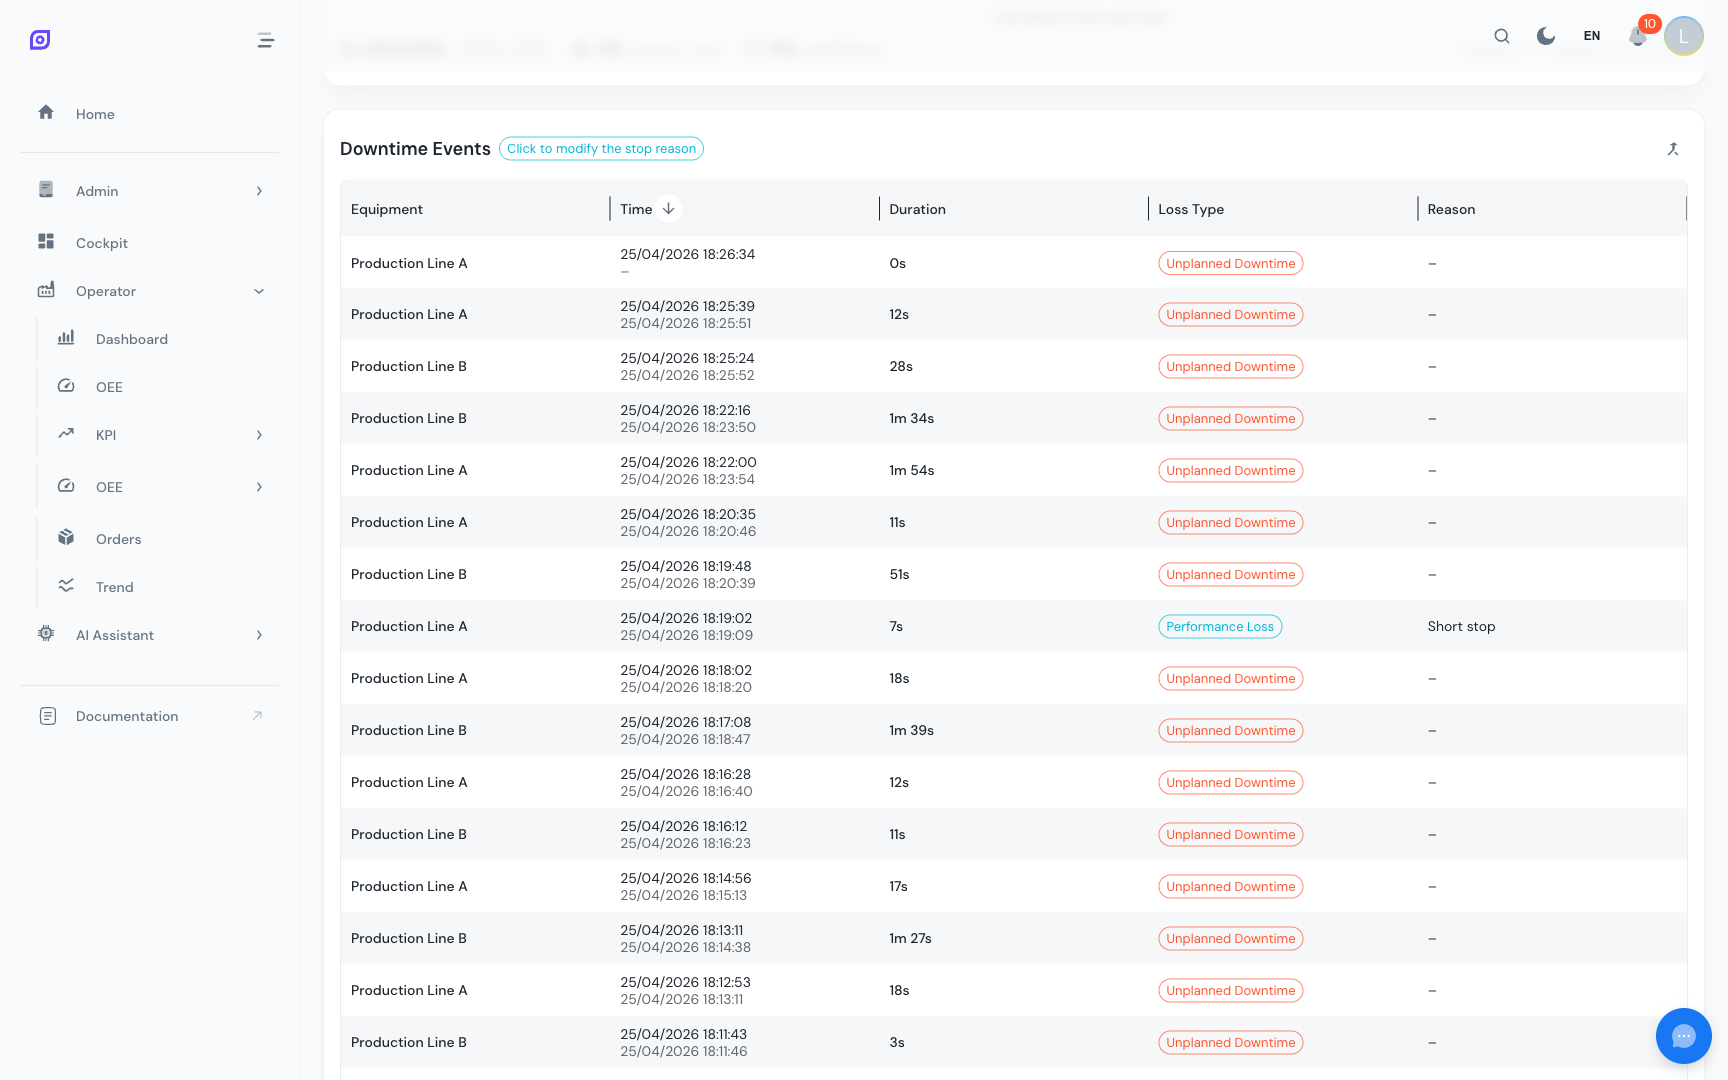
タイムラインの下のDataGridは、ソート可能でフィルター可能な列ですべてのイベントを一覧表示します。
| 列 | 説明 |
|---|---|
| 設備 | 設備名 |
| 開始時刻 | イベントが開始した時刻 |
| 終了時刻 | イベントが終了した時刻 |
| 期間 | イベントの長さ(時間、分、または秒でフォーマット) |
| 理由(レベル0〜3) | 階層的な理由分類 |
| サブ設備 | どのサブコンポーネントが停止を引き起こしたか(該当する場合) |
| 損失タイプ | カテゴリ: 計画、計画外、エリア外など |
| 検証済み | 理由が割り当てられたかどうか |
| コメント | オペレーターのメモ |
| ステータス | 現在の操作ステータス |
| アクション | 編集、分割、その他の操作 |
列の表示
列の表示切り替えを使用して、コンパクトビュー(必須列のみ)と完全ビュー(サブ設備、コメント、ステータスを含むすべての列)を切り替えます。
イベントの分類(理由割り当て)
オペレーターの最も重要なタスクは、ダウンタイムイベントに理由を割り当てることです。イベントの 編集 アクションをクリック(またはタイムラインピルをクリック)して、理由選択パネルを開きます。
理由選択パネル
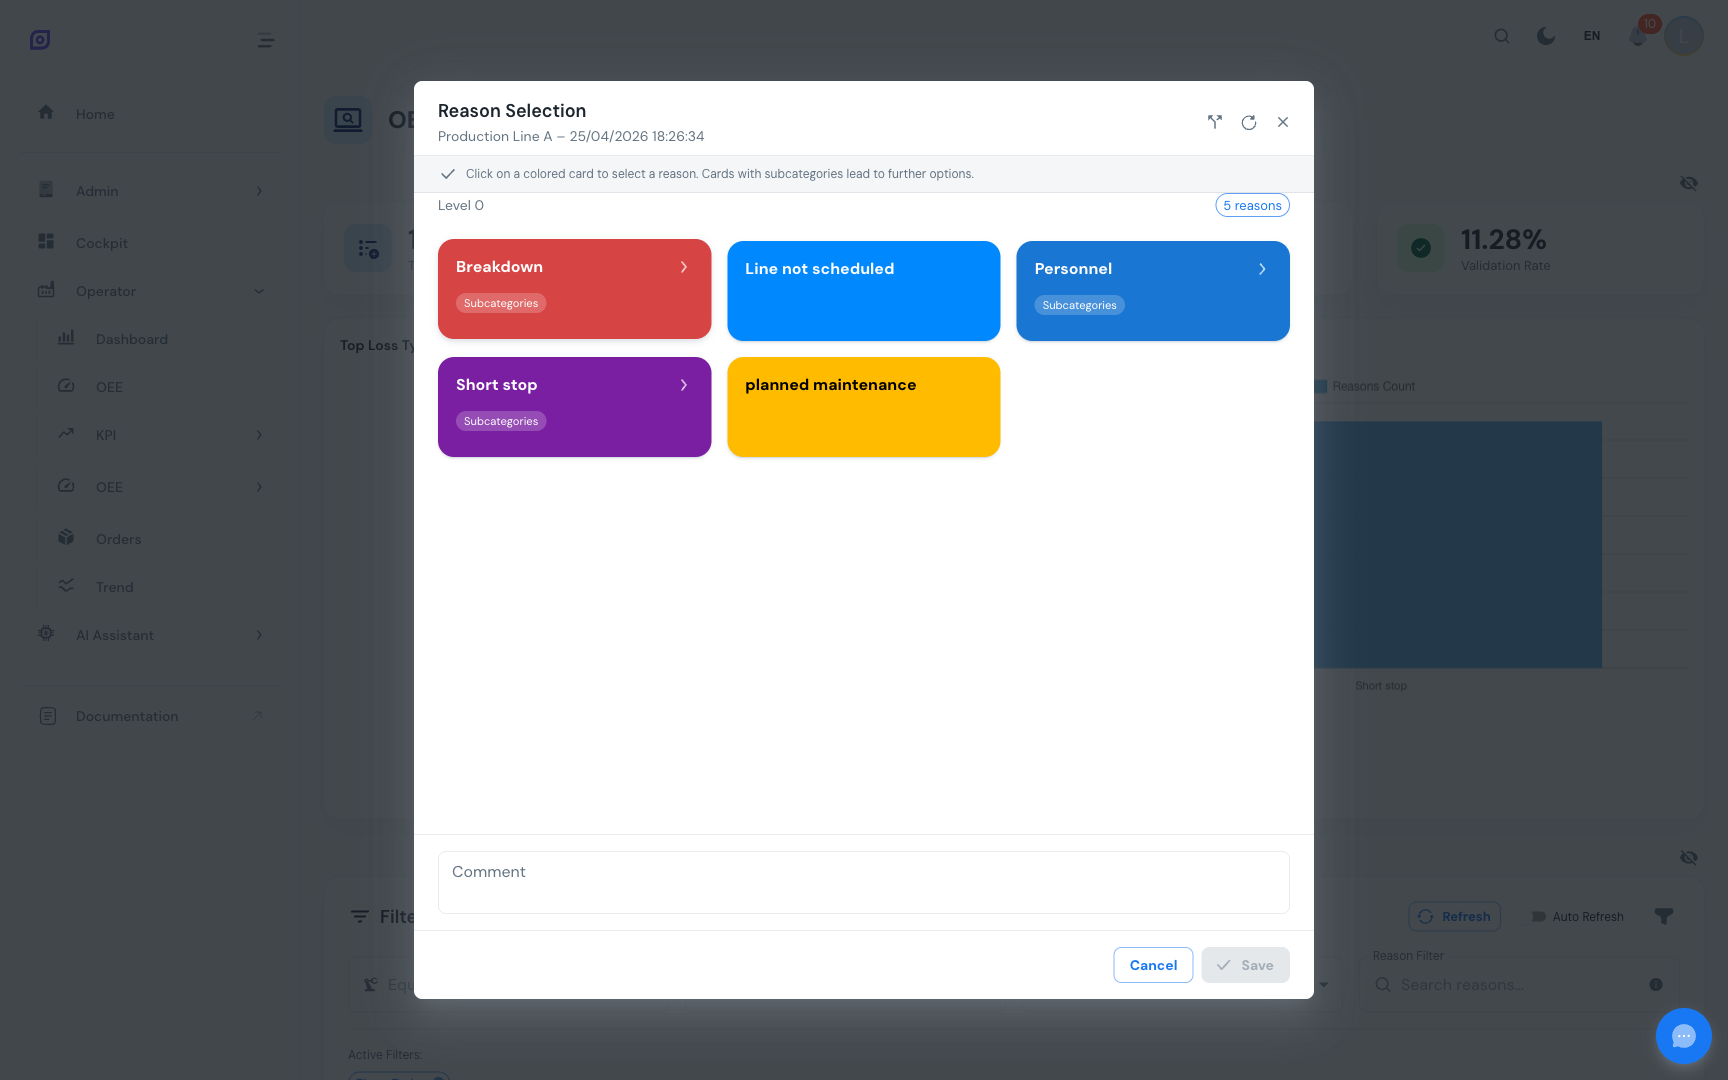
パネルには、サイト用に構成された階層的な理由ツリーが表示されます。
- レベル0: トップレベルカテゴリ(例:「機械」「電気」「プロセス」)
- レベル1: サブカテゴリ(例:「モーター」「センサー」「材料」)
- レベル2: 具体的な理由(例:「ベアリング故障」「近接センサー」「フィルム破れ」)
- レベル3: 詳細(オプション、非常に細かい分類用)
各レベルで適切な理由を選択します。次のことも可能です。
- 停止を引き起こしたコンポーネントを特定するための サブ設備 を選択
- 自由テキストメモを含む コメント を追加
- 損失タイプ 分類を変更
保存後、イベントは検証済みとマークされ、検証率が増加します。
シフト間で一貫した理由分類は、正確なパレート分析にとって重要です。異なるオペレーターが異なる方法で説明する場合でも、同じ種類の問題には同じ理由を使用してください。階層構造はこの一貫性を強化するのに役立ちます。
イベントの分割
長い1つのダウンタイムイベントが、実際には複数の異なる原因を含んでいる場合があります。分割 アクションを使用して、1つのイベントを2つに分割します。
分割の方法
- イベント行の 分割 アクションボタンをクリックします。
- 分割ポイント(時刻または期間)を入力します。
- 分割を確認します。
- 2つの新しいイベントが作成されます。それぞれを独自の理由で分類してください。
分割操作は POST /api/production/oee/availability/{id}/split を呼び出し、元のものから2つの新しいレコードを作成します。
イベントの統合
システムが複数の短いイベントを検出し、それらが本当は1つの連続したダウンタイムである場合(例:マシンが2つの停止間で2秒間ちらつくように再起動した)、統合 を使用してそれらを結合します。
統合の方法
テーブルから:
- トグルボタンを使用して 統合モード を有効にします。
- それらの行をチェックして2つ以上のイベントを選択します。
- 選択を統合 をクリックします。
- 統合を確認すると、全時間範囲をカバーする単一のイベントが作成されます。
タイムラインから:
- 最初のイベントピルをクリックします。
- 2番目のイベントピルを Shift+クリック します。
- 表示されるダイアログで統合を確認します。
統合操作は POST /api/production/oee/availability/merge を選択されたイベントIDで呼び出します。
統合は同じ設備のイベントに対してのみ可能です。統合されたイベントは、最も早いイベントの開始時刻と最も遅いイベントの終了時刻を継承します。
可用性レコードフィールド
APIによって返される各可用性レコードには次が含まれます。
| フィールド | 説明 |
|---|---|
id | 一意のレコード識別子 |
equipment_id / equipment_name | 設備への参照 |
start_time / end_time | イベントの時間境界 |
delta | 期間(秒) |
adjusted_delta | クエリウィンドウの境界に切り取られた期間 |
sub_equipment_id / sub_equipment_name | サブコンポーネントの詳細 |
reason_id_0 から reason_id_3 | 階層的な理由ID |
reason_0 から reason_3 | 階層的な理由名(翻訳済み) |
comment | オペレーターの自由テキストメモ |
type_id / loss_type | 損失タイプ分類 |
validated | 理由が割り当てられたかどうか |
status_id / status_name | 操作ステータス |
permissions | このレコードに対するユーザーの権限レベル |
APIエンドポイント
| エンドポイント | メソッド | 目的 |
|---|---|---|
/api/production/oee/availability/ | GET | フィルター付きで可用性イベントを一覧表示 |
/api/production/oee/availability/equipment/{id} | GET | 特定設備のイベント |
/api/production/oee/availability/summary | GET | 集計統計 |
/api/production/oee/availability/reasons | GET | 利用可能な理由コード |
/api/production/oee/availability/record/{id} | GET | 単一レコードの詳細 |
/api/production/oee/availability/{id} | PUT | レコードの更新(理由、コメントなどを割り当て) |
/api/production/oee/availability/{id}/split | POST | 1つのイベントを2つに分割 |
/api/production/oee/availability/merge | POST | 複数のイベントを1つに統合 |
オペレーターのベストプラクティス
- イベントを迅速に検証: 詳細が新鮮なうちに、イベント中またはイベント直後にダウンタイム理由を分類してください。
- 正しい理由レベルを使用: 階層的に可能な限り深く進みます。「機械 > モーター > ベアリング故障」は単に「機械」よりもはるかに有用です。
- 異常な状況にはコメントを追加: 自由テキストはメンテナンスチームがコンテキストを理解するのに役立ちます。
- 根本原因がイベントの途中で変わった場合は長いイベントを分割 します。
- ちらつきイベントを統合: 関連する2つの停止間でマシンが短時間再起動した場合、それらを1つのイベントに統合します。
- シフトの終わりに 検証率を確認: 100%を目指します。
関連ページ
- OEEダッシュボード: ダウンタイムイベントが全体OEEにどう影響するかを確認
- OEEパフォーマンス: 速度損失と停止損失を調査
- 設備概要: 複数のラインのダウンタイムを比較
- OEE構成: 損失タイプと理由階層を構成
- コックピット — ダウンタイムタイムライン: コックピットのタイムラインウィジェット